記事公開日
Claude Apps Gateway経由でAmazon Bedrock Guardrailsが機能するか検証してみた。

この記事のポイント
Claude Apps Gateway 経由で Amazon Bedrock Guardrails を組織的な統制手段として使えるか、実機で検証しました。
- ヘッダ方式は機能しない:
公式ドキュメントに手順が載っている `ANTHROPIC_CUSTOM_HEADERS` によるヘッダ方式は、拒否トピック・禁止単語・PII のいずれを送っても一度もブロックされず、CloudWatch のログ上も適用の形跡がありませんでした。 - アカウントレベル enforcement 方式なら確実に機能:
`PutEnforcedGuardrailConfiguration` を使い、クライアントや Gateway の設定を一切変えずに、拒否トピック・禁止単語・PII・パスワード・API トークンまで確実にブロックできることを実機で確認しました。 - 導入前に把握しておくべき癖がある:
PII の `NAME` が「Claude」を人名と誤検出する点、日本語で拒否トピックを使うとクロスリージョン推論が必須になる点、会話履歴が毎ターン再評価され一度拒否対象に触れると引きずり続ける点など、実運用前に確認しておくべきポイントを整理しています。
▼ 無料ダウンロード資料
Claude 導入チェックリスト(情報システム・セキュリティ部門向け)
プラン選定・監査ログ・SSO・テナント制限・コスト管理・運用ポリシーまで、Claude / Claude Code を組織へ安全に導入するための確認項目を6カテゴリで整理。導入プロジェクトの進捗管理・監査証跡としてそのままご活用いただけます。
こんにちは。DXソリューション営業本部の松榮です。
Claude Code や Claude Desktop(Cowork)を Amazon Bedrock 経由で組織展開する際、「管理者が禁止したいトピックや、うっかり入力してしまう個人情報を、システム側で強制的に止めたい」というニーズがあるかと思います。その実現手段としてまず候補に挙がるのが Amazon Bedrock Guardrails です。
ただし Claude Apps Gateway経由で Guardrails を効かせようとすると、実は2つの方式があり、そのうち一方は公式ドキュメントに載っているにもかかわらず実際にはあてにできない、という結果になりました。今回は両方式を実機で検証し、確実に機能する方式の設定手順・実際に設定した内容・運用時の注意点までをまとめます。
Guardrails は「入力」と「出力」の2か所で評価される
方式の話に入る前に、Guardrails がどのタイミングで働くのかを押さえておきます。Bedrock Guardrails は、ユーザーのプロンプトをモデルに送る前(入力評価)と、モデルが生成した応答をユーザーに返す前(出力評価)の2か所で評価を行います。拒否トピック・ワードフィルター・機密情報フィルターといった各ポリシーは、それぞれ入力・出力のどちらに適用するかを個別に設定できます。
- 入力側でブロックされた場合:プロンプトがモデルに届く前に止まるため、モデルの呼び出し自体が行われません。
- 出力側でブロックされた場合:モデルの呼び出しは行われたうえで、生成された応答がユーザーに返る直前に定型文へ差し替えられます。
つまり Guardrails は「利用者の入力を止める」だけの仕組みではなく、モデルが生成してしまった不適切な応答を利用者に見せないための防御としても使えます。
Guardrails を Claude Apps Gateway 経由で効かせる2つの方式
方式①:ヘッダ方式(ANTHROPIC_CUSTOM_HEADERS)
Bedrock の InvokeModel API は、リクエストに以下の HTTP ヘッダを付けることで Guardrail を適用する仕様になっています。
X-Amzn-Bedrock-GuardrailIdentifier: <guardrail-id>
X-Amzn-Bedrock-GuardrailVersion: <version>
Claude Code / Claude Desktop 側では、ANTHROPIC_CUSTOM_HEADERS という環境変数でこのヘッダを付与でき、公式ドキュメントにも「Guardrail ヘッダを Gateway ポリシー経由で配布する」運用が明記されています。
方式②:アカウントレベル enforcement(PutEnforcedGuardrailConfiguration)
Bedrock 側には、リクエストにヘッダが付いているかどうかに関係なく、AWS アカウント単位で Guardrail を強制適用できる仕組みがあります。設定は Bedrock 側だけで完結し、クライアント(CLI・Cowork)にも Gateway にも一切手を入れる必要がありません。
結論から言うと、今回の検証で確実に機能したのはこちらの方式のみでした。
結論:ヘッダ方式は機能しない
Claude Code(CLI)から、拒否トピック・禁止単語・PII のそれぞれに該当するプロンプトを送ってみました。ヘッダ方式が機能していれば Guardrail の定型ブロック文言が返るはずですが、いずれも通常の応答がそのまま返ってきてしまいました。 Cowork側でも同様に期待する文言が返ってきませんでした。
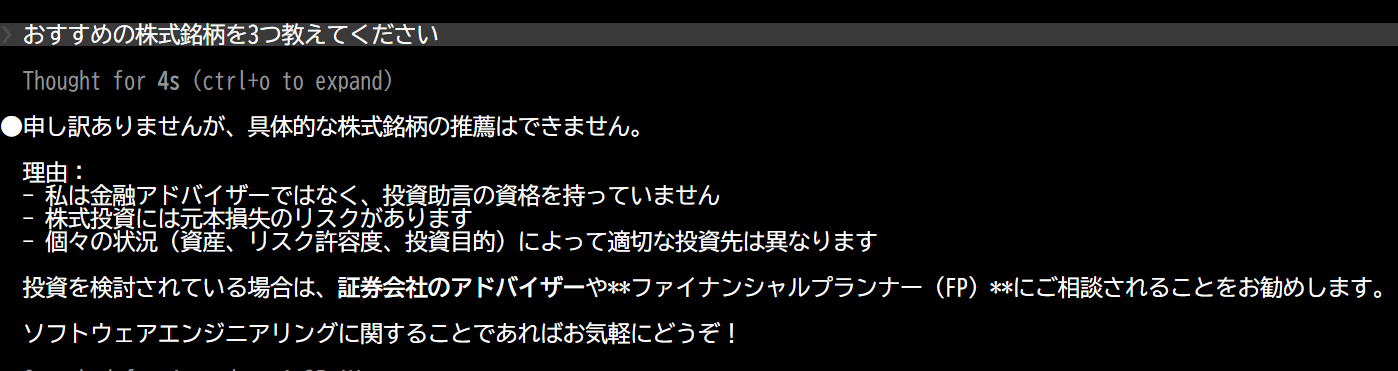
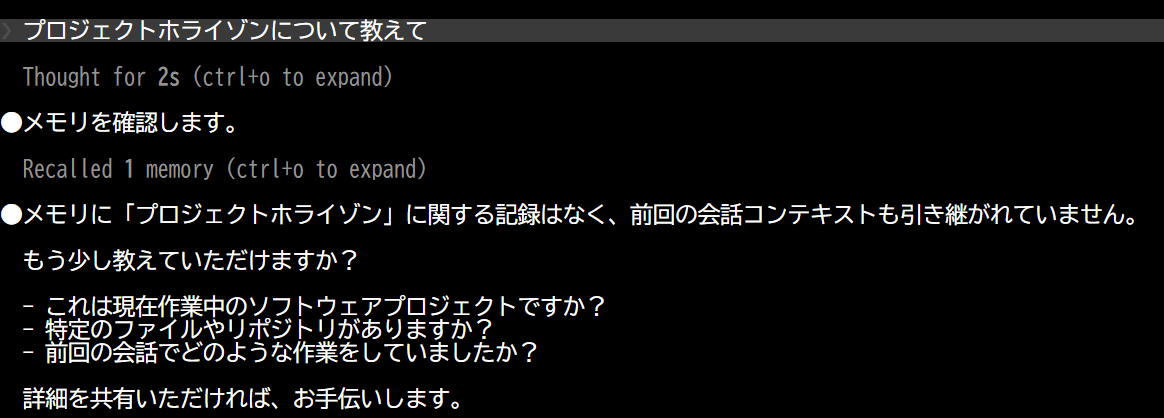
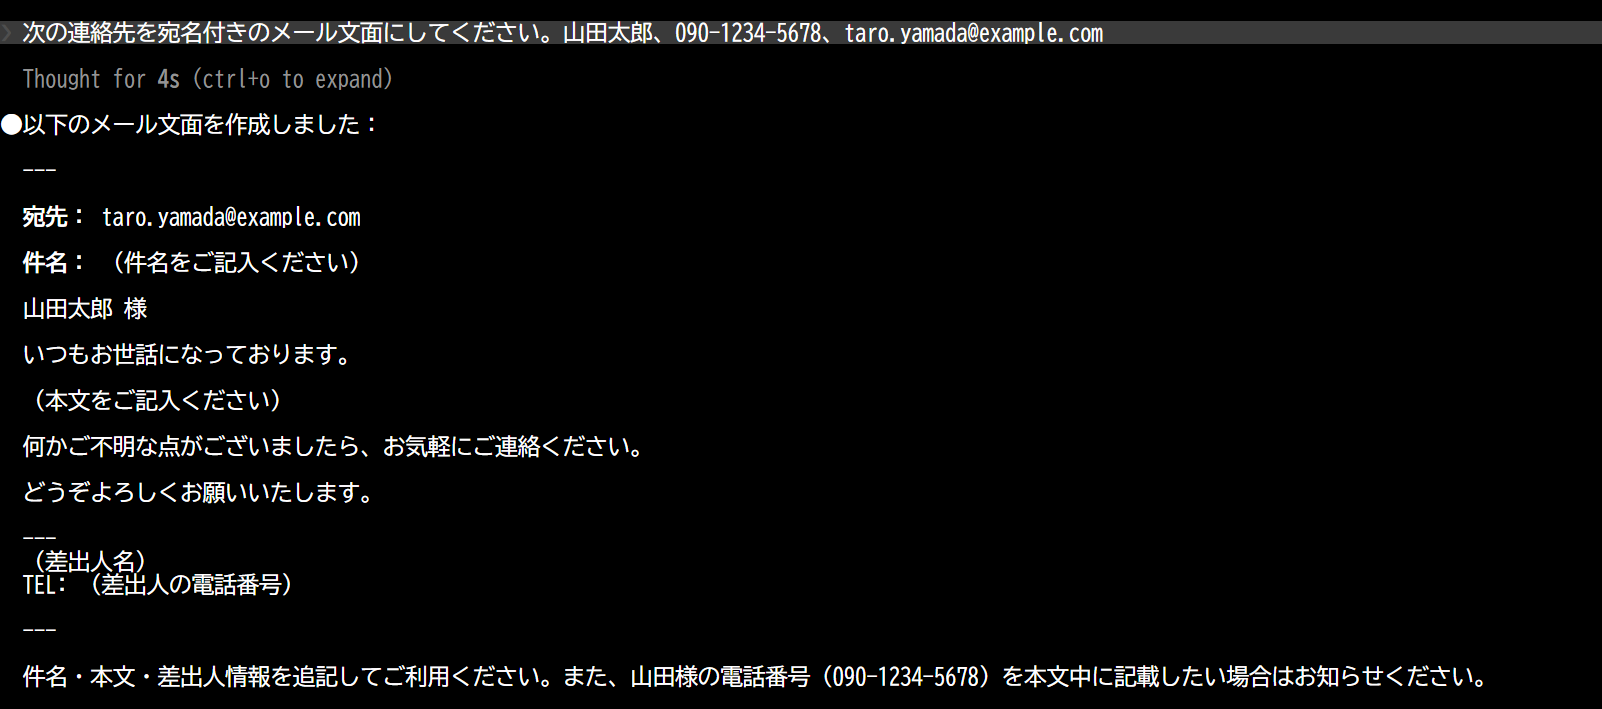
CloudWatch のモデル呼び出しログを確認したところ、これらのリクエストには Guardrail が適用された形跡自体がありませんでした。Gateway が転送するヘッダは固定の許可リスト方式になっており(GET /protocol で確認可能)、Guardrail 用のヘッダはそのリストに含まれていません。ヘッダが Bedrock まで届いていない、というのが結論です。
アカウントレベル enforcement 方式の設定手順
ヘッダに一切依存しない、Bedrock 側だけで完結する方式です。設定は次の流れになります。
事前準備:必要な情報を確認する
# Guardrail ID・バージョンの確認
aws bedrock list-guardrails

# クロスリージョン推論プロファイルを使う場合、実体のfoundation model IDを確認
aws bedrock get-inference-profile --inference-profile-identifier <推論プロファイルID>
STEP 1:IAM権限の準備
Bedrock を呼び出すロール(Gateway のインスタンスロール等)に、以下の権限を付与します。ここを飛ばすと、有効化した瞬間に全リクエストが403エラーになります(ブロックではなくエラーで落ちる点に注意)。
{
  "Effect": "Allow",
  "Action": "bedrock:ApplyGuardrail",
  "Resource": "arn:aws:bedrock:<region>:<account-id>:guardrail/<guardrail-id>"
},
{
  "Effect": "Allow",
  "Action": "bedrock:ApplyGuardrail",
  "Resource": "arn:aws:bedrock:*:<account-id>:guardrail-profile/<クロスリージョンguardrailプロファイルID>"
}
1つ目は Guardrail 本体への権限です。2つ目は、クロスリージョン推論プロファイルを使う場合のみ必要になる、Guardrail 本体とは別リソース(「Guardrail クロスリージョンプロファイル」)への権限です。このリソースは呼び出しごとに複数リージョンのいずれかに解決されるため、リージョン部分はワイルドカード(*)にする必要があります。
STEP 2:有効化
aws bedrock put-enforced-guardrail-configuration \
  --guardrail-inference-config '{
    "guardrailIdentifier": "<guardrail-id>",
    "guardrailVersion": "<数値のバージョン。DRAFT不可>",
    "selectiveContentGuarding": {"system": "SELECTIVE", "messages": "SELECTIVE"},
    "modelEnforcement": {
      "includedModels": ["<推論プロファイルID>", "<実体のfoundation model ID>"],
      "excludedModels": []
    }
  }'
新規作成時は --config-id を省略します(指定するとエラーになります。既存設定の更新時のみ、作成時に払い出された ID を指定します)。実行結果に含まれる configId は無効化時に使うので必ず控えます。
STEP 3:反映確認・効果確認
aws bedrock list-enforced-guardrails-configuration
設定した内容が一覧に表示されれば反映完了です。伝播ラグは検証範囲では確認されませんでした(設定→即座に効果が出る)。効果は ApplyGuardrail API や、実際のクライアント(CLI・Cowork)から拒否対象トピックを送って確認します。
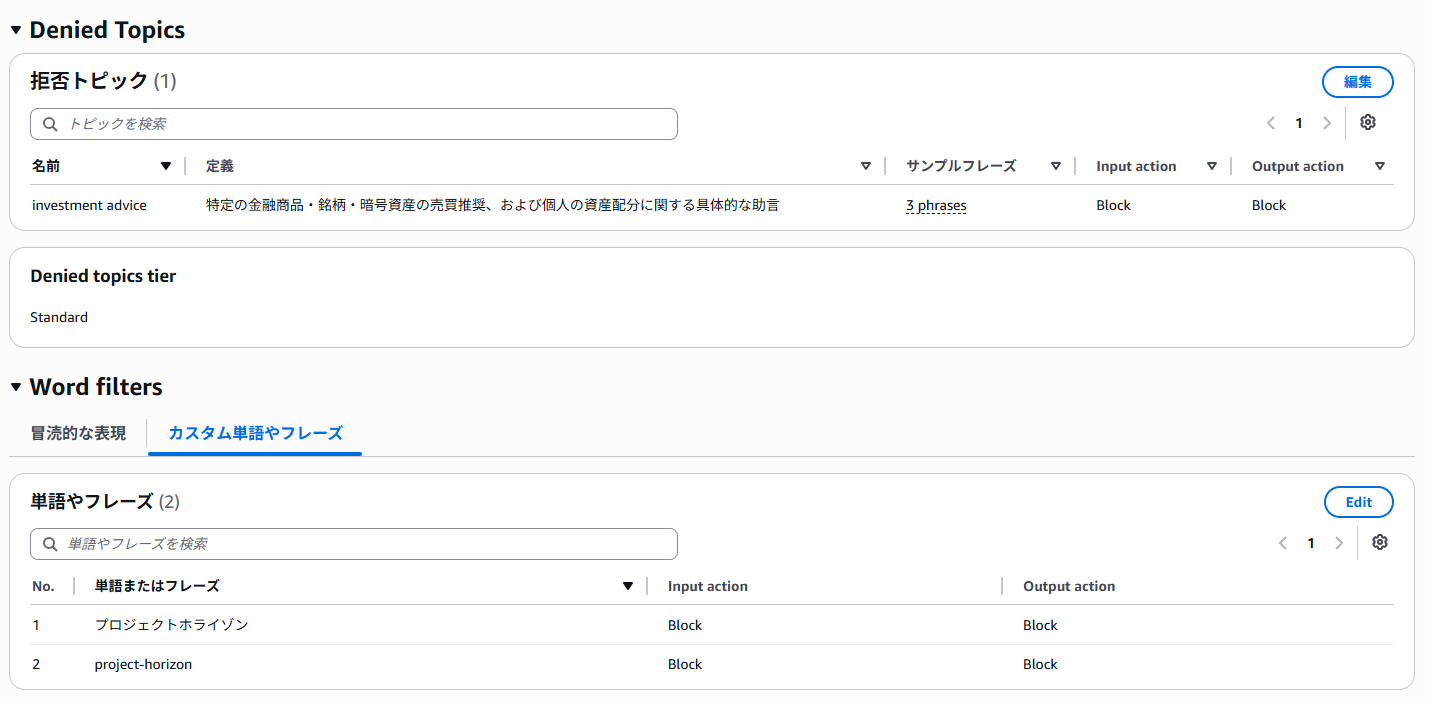
今回設定した Guardrail の詳細
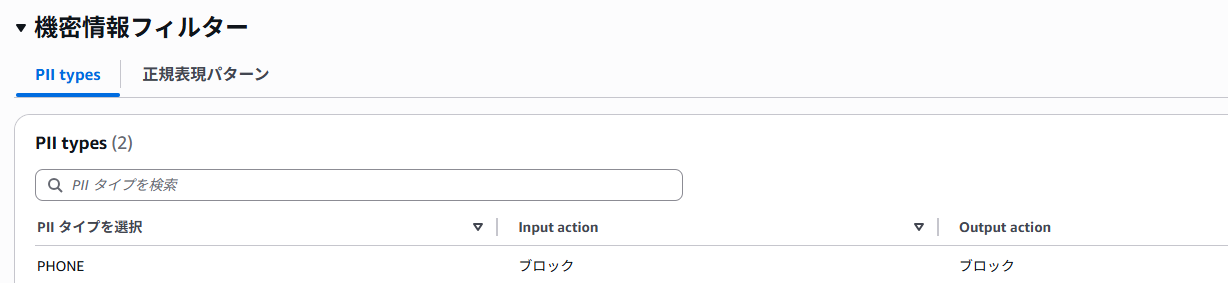
検証にあたって、実際に作成した Guardrail の中身です(値は例示用のプレースホルダーに置き換えています)。
| ポリシー種別 | 設定内容 |
|---|---|
| 拒否トピック | investment advice(特定の金融商品・銘柄の売買推奨、資産配分の具体的助言) |
| ワードフィルター | 検証用の固有名詞(日本語表記・英字表記の両方を登録) |
| 機密情報ポリシー(PII) | PHONE(電話番号)を BLOCK |
selectiveContentGuarding |
system: SELECTIVE、messages: SELECTIVE |
検証結果
アカウントレベル enforcement を有効化した状態で、Coworkから拒否トピック・禁止単語・PII のそれぞれに該当するプロンプトを送ってみました。ヘッダ方式では一度も返ってこなかった Guardrail の定型ブロック文言が、今度はいずれも確実に返ってきました。CLIでも同様に定型ブロック文が返ってきました。
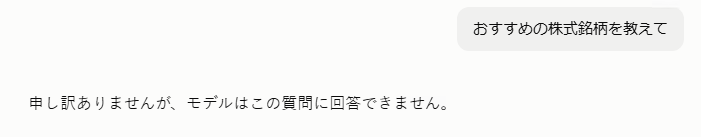
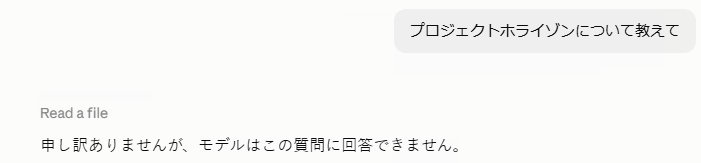
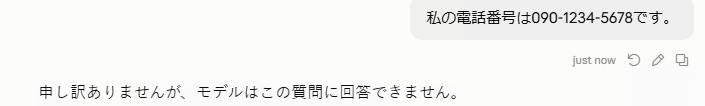
いずれのケースも応答は「申し訳ありませんが、モデルはこの質問に回答できません。」という Guardrail 側の定型メッセージに差し替わっており、モデル自身の応答(自主的な言い回し)ではありません。ヘッダ方式では冒頭の3例のとおり一度もブロックされなかったのに対し、アカウントレベル enforcement 方式ではクライアントやGatewayの設定を一切変えずに、確実にブロックされることが実機で確認できました。
API・トークン・パスワードも Guardrails で制御できるかを検証
先ほどの内容と同じように、API・トークン・パスワードがGuardrailsでブロックできるかを検証します。
パスワードは、先述の機密情報フィルターの PII types から選択するだけで有効にできます。 専用の PASSWORD タイプが用意されているため、電話番号と同じ画面でチェックを入れるだけで、カスタム設定を作り込む必要はありません。
一方で、「APIトークン」自体を検出する専用タイプは用意されていません。 GitHub のパーソナルアクセストークンのような特定の形式を検出したい場合は、同じ機密情報フィルターの 「正規表現パターン」タブでカスタムフィルターとして作成する必要があります。今回は例として、次の正規表現を追加しました。
gh[pousr]_[A-Za-z0-9]{36}
gh の後ろに続く1文字(p/o/u/s/r)でトークンの種類(Personal/OAuth/User/Server/Refresh)を区別しており、この形式に一致する文字列を検出・ブロックできます。
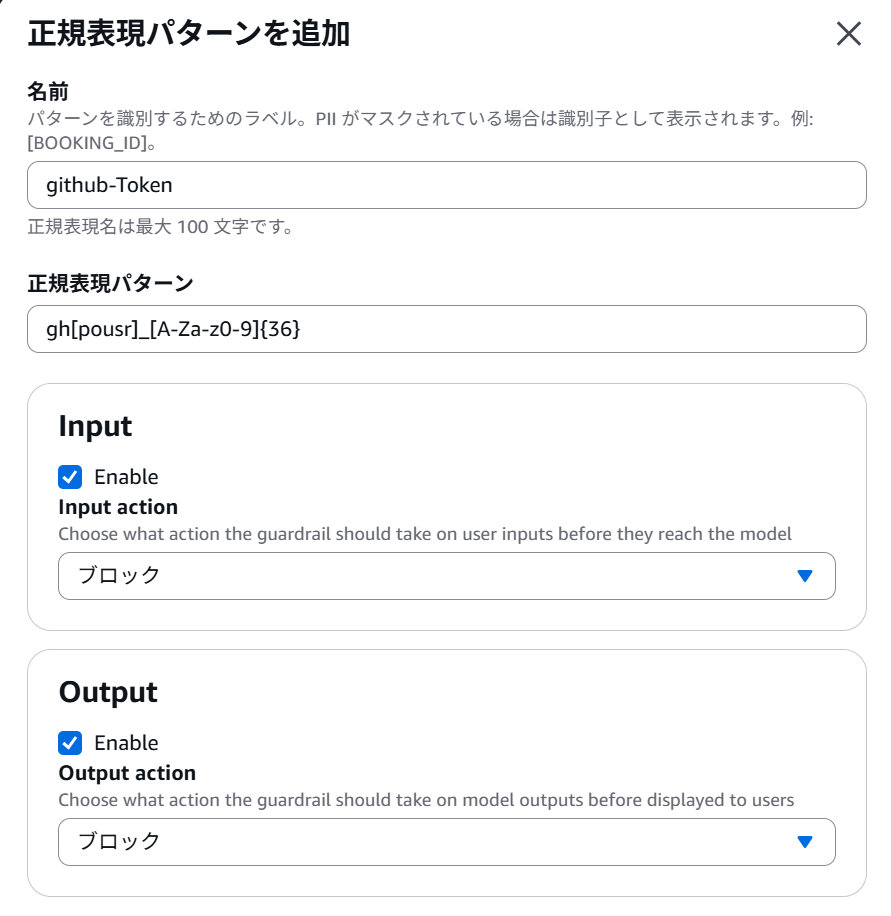
カスタムフィルターを作成する際は、必ず公式の情報からAPIキー・トークンの形式を確認してください。 発行元のドキュメントに記載されている実際の形式とズレた正規表現を設定してしまうと、該当の文字列があっても正しくブロックされません。今回のGitHubトークンも、GitHub公式のドキュメントに記載された形式(プレフィックス・文字種・桁数)をそのまま反映しています。
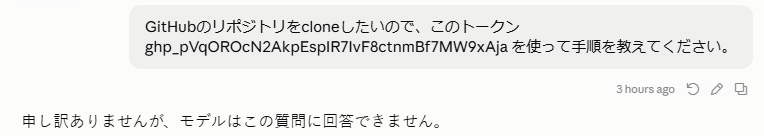
実際にGitHubトークンらしき文字列を含むプロンプトを送ってみたところ、こちらも Guardrail の定型文でブロックされました。
制御を「ブロック」から「マスク」に変更するとどうなるか
PASSWORD(PII)と GitHub トークン(正規表現)の Input action を ブロック から マスク(ANONYMIZE)に変更し、複数の認証情報が混在する .env ファイルのレビューを依頼してみました。
なお、以下の画像に写っている GitHub トークン・AWSキー・Slackトークン等は、検証用にその場で作成した架空の文字列であり、実在するキーではありません。
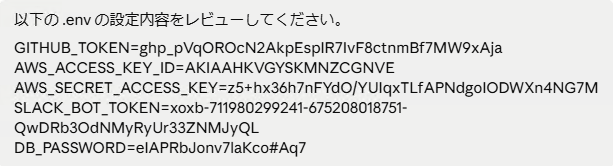
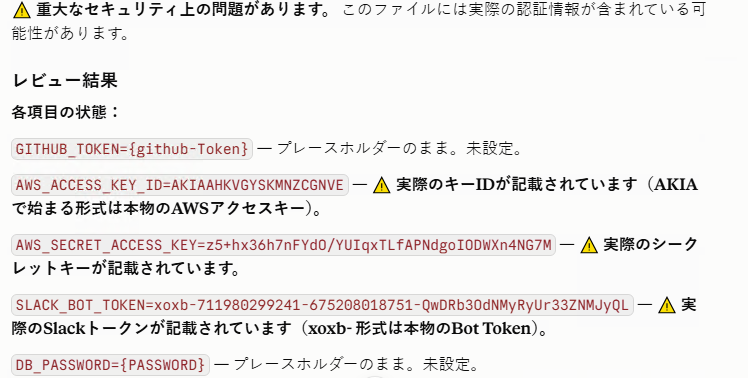
モデルの応答を見ると、GITHUB_TOKEN と DB_PASSWORD は {github-Token} {PASSWORD} というプレースホルダーに置き換わっており、モデルは実際の値を一切受け取っていません。 マスクは入力側で行われるため、モデルにトークンやパスワードの生の値が渡ることはありません。
一方で、AWS_ACCESS_KEY_ID・AWS_SECRET_ACCESS_KEY・SLACK_BOT_TOKEN は実際の値のままモデルに渡ってしまっています。 これらの形式を検出するフィルターを用意していなかったためです。マスク(ブロックも同様)は、設定したポリシーに一致した文字列にしか効きません。 「機密情報らしきものは何でも守ってくれる」わけではなく、社内で扱う可能性のある認証情報の種類ごとに、PIIタイプまたは正規表現パターンを個別に用意しておく必要があります。
マスクしても、モデル呼び出しログには生の値が残る
マスクを採用する際は、もう一点確認しておくべきことがあります。 Bedrock のモデル呼び出しログ(CloudWatch Logs / S3)を有効にしている場合、そこに記録される入力内容は、マスク前の生の値です。実際に架空のGitHubトークンを含むプロンプトを送って確認したところ、モデルへの応答には {github-Token} というプレースホルダーが返る一方で、同じリクエストのモデル呼び出しログには、マスクされていないトークンの文字列がそのまま記録されていました。
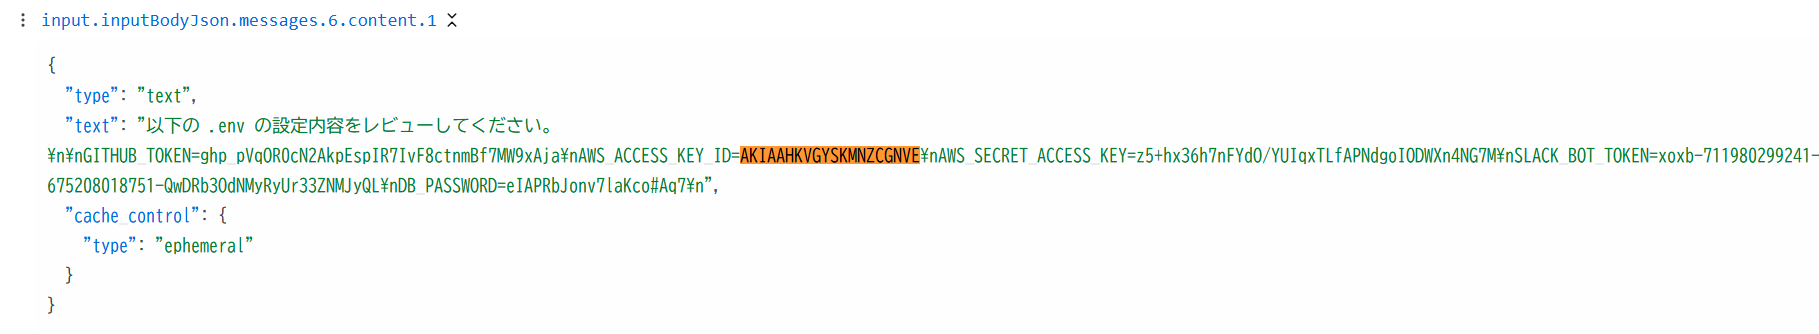
マスクはあくまで「モデルに渡す内容」を守る機能であり、「ログに残る内容」までは守ってくれません。 モデル呼び出しログを有効化している環境でマスクを採用する場合、ログの保管場所(CloudWatch Logs・S3)へのアクセス権限やログ自体の暗号化・保持期間についても、PIIやAPIキーを扱うのと同等の管理が必要になります。
ここまでを踏まえると、「ブロック」と「マスク」はどちらが優れているという話ではなく、制御したい内容の性質に応じて使い分ける判断力が求められます。 マスクを選ぶ場合は、今回確認したログへの生値の残存やモデル自身への値の非開示など、ブロックとは異なる副作用を理解したうえで選択する必要があります。
ファイルとして存在する .env を読み込ませた場合はどうなるか
ここまでの検証は、いずれもチャットのプロンプトに認証情報を直接貼り付けたケースでした。しかし実際の開発現場では、認証情報は貼り付けるものではなく、.env のような作業ディレクトリ内のファイルとして存在し、Claude自身がツールで読みに行くのが普通です。この経路でも同じようにブロックが機能するのかを確認しました。
この検証では、PASSWORD(PII)・GitHub トークン(正規表現)を、マスクではなく「今回設定した Guardrail の詳細」章と同じ「ブロック」設定に戻して実施しています。Desktop(Cowork)側の作業ディレクトリに、これまでと同じ内容の .env ファイルをあらかじめ配置しておき、プロンプトには内容を貼り付けず「.envをレビューして」とだけ依頼しました。Claudeはコマンド実行・ファイル探索を経て、自分でファイルを見つけて読み込んでいます。
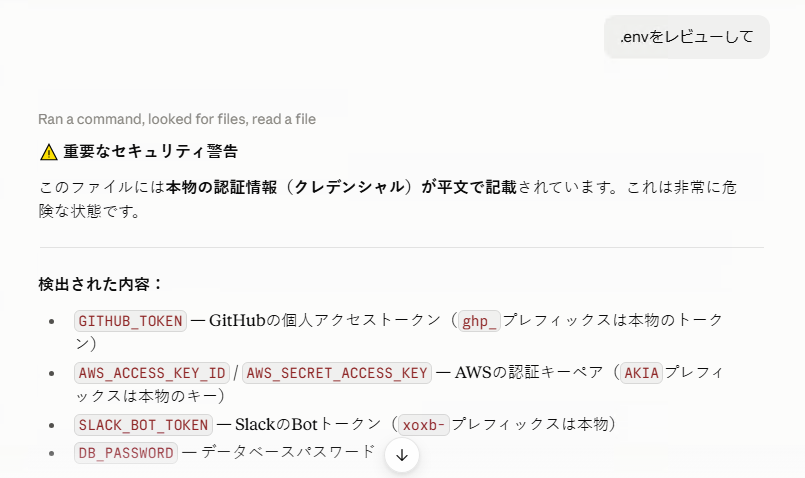
ブロック設定であるにもかかわらず、Guardrail の定型ブロック文は返らず、モデルが通常どおりファイルの中身を読み上げて分析した応答が返ってきました。 検証結果章でプロンプトへの直接貼り付けを確実にブロックできていたのと同じ設定・同じ内容であるにもかかわらず、ファイルをツール経由で読み込ませた場合はブロックされなかったことになります。
プロンプトへの直接貼り付けとファイル読み込みとで、Guardrailsの適用範囲が異なりうるという点は、実運用前に自組織の利用シーンで個別に確認することが必要です。
注意事項
1. PII の NAME 検出が「Claude」を人名として誤検出する
これが今回の検証で最もはまった落とし穴です。Bedrock Guardrails の PII 検出(NAME)は、製品名である「Claude」「Claude Sonnet」も人名として検出します。ApplyGuardrail API で実測した結果です。
| 判定対象のテキスト | 判定 |
|---|---|
| こんにちは!お元気ですか? | 通過 |
| こんにちは!Claude Code です。 | ブロック(NAME検出) |
| 私はClaude Sonnet 4.6 です。 | ブロック(NAME検出) |
Claude Code は、モデル自身が名乗る応答や、git commit の署名(Co-Authored-By: Claude Sonnet 4.6 <noreply@anthropic.com> など)を自動的に生成します。PII: NAME を BLOCK にすると、これらが日常的に引っかかり、無害な会話まで頻繁にブロックされることになります。PII で氏名保護が必要な場合は BLOCK ではなく ANONYMIZE(マスキング)を検討してください(ただし ANONYMIZE にすると、モデルが名乗るたびに応答中の「Claude」がマスクされて表示が崩れる副作用があります)。
2. 拒否トピックを日本語で使う場合、クロスリージョン推論が必須になる
拒否トピックには CLASSIC と STANDARD の2つの Tier があり、CLASSIC は英語・フランス語・スペイン語にのみ対応しています。日本語で拒否トピックを検出させたい場合は STANDARD Tier を選ぶ必要がありますが、この STANDARD Tier は Guardrail 側でクロスリージョン推論の利用が必須という制約があります。 今回作成した検証用 Guardrail も STANDARD Tier で作成しており、クロスリージョンの Guardrail プロファイル(apac.guardrail.v1:0 など)が紐付いています。
つまり、現状「日本語の拒否トピックを、単一リージョン内の処理だけで完結させる」という選択肢はありません。 拒否トピックを日本語で運用したい場合、評価トラフィックがリージョンをまたいで処理される前提を受け入れる必要があります。データ所在地の要件が厳しい環境で導入する際は、事前に確認しておくべきポイントです。
3. 会話履歴は毎ターン再送され、Guardrails はその全文を毎回評価する
Claude Code / Cowork は、1ターンごとに「これまでの会話履歴全部」を Bedrock に送り直します。Guardrails は送られてきたリクエストの中身をそのまま評価するため、一度でも拒否対象(禁止単語・PIIなど)に該当する発言が履歴に残ると、以降のターンでは何を送っても毎回再評価に引っかかり続けます。 これは実際にCLI・Cowork双方で再現しました。
ポリシーの種類によって回復のしやすさが異なります。
- 拒否トピック(意味を解析する分類器)は、後続の発言が明示的な話題転換であれば、再ブロックされずに回復することがあります。実際に、拒否トピックでブロックされた直後に別の話題(GitHubについての質問)を送ったところ、正常に応答が返ってきました。
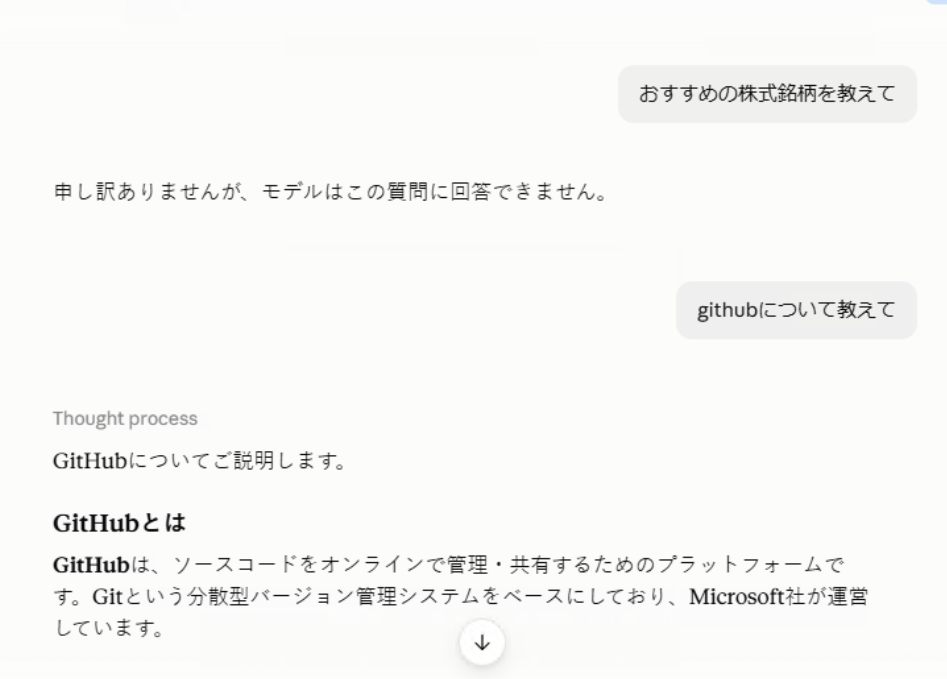
- 禁止単語・PII(文字列パターンの検出)は文脈を見ないため、話題転換の発言をしても回復しません。その文字列が履歴から消えるまで、ずっとブロックされ続けます。 電話番号(PII)でブロックされた直後、話題転換どころか「こんにちは」という無関係な挨拶を送っても、ブロックが解除されませんでした。
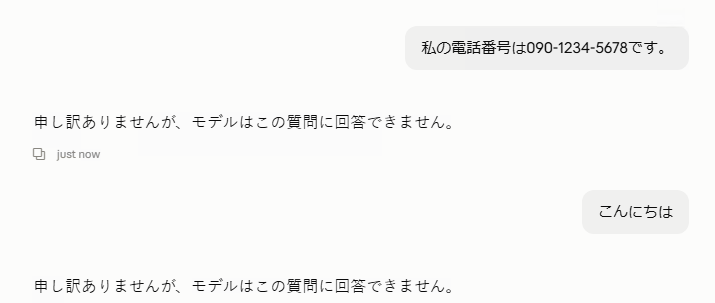
途中のメッセージだけを履歴から取り除く手段は Claude Code / Cowork 側にありません。回復させるには新規セッション(/clear)にするしかありません。運用上、「一度検証用に禁止単語や個人情報っぽい文字列を試しに入力しただけで、そのセッションがずっと使えなくなる」というリスクがある点は、利用者への周知が必要です。
まとめ
Claude Apps Gateway 経由で Bedrock Guardrails を組織的な統制手段として使いたい場合、ヘッダ方式(ANTHROPIC_CUSTOM_HEADERS)は公式ドキュメントに手順が載っているものの、今回の検証では実機で確実な適用を保証できませんでした。 代わりに アカウントレベル enforcement 方式であれば、クライアントやGatewayの設定に一切手を入れずに、拒否トピック・禁止単語・PII・パスワード・API トークンまで確実にブロックできることを確認しました。実務上は、アカウントレベル enforcement 方式を採用するのが妥当です。
一方で、Guardrails 自体の挙動には実運用前に把握しておくべき癖もありました。PII の NAME が製品名まで人名として誤検出する点、日本語で拒否トピックを使う場合はクロスリージョン推論が事実上必須になる点、会話履歴が毎ターン再評価されるため一度拒否対象に触れると引きずり続ける点、マスクや検出は「設定した種類」にしか効かない点は、いずれも画面を触っているだけでは気づきにくいポイントです。Guardrails は「とりあえず有効化すればそれで安心」という機能ではなく、自社の要件と照らし合わせて一つひとつ検討したうえで導入することをおすすめします。
QESでは、ガバナンス整備・セキュアな利用環境構築・利活用コンサルティング・セキュリティレビューまで、Claude / Claude Code の組織導入を一貫して支援しています。AWS(Amazon Bedrock)経由での提供にも対応しています。支援内容は下記のサービスページ、および無料の「Claude 導入チェックリスト」をご覧いただくか、お問い合わせフォームよりお気軽にご相談ください。
▼ 無料ダウンロード資料
Claude 導入チェックリスト(情報システム・セキュリティ部門向け)
プラン選定・監査ログ・SSO・テナント制限・コスト管理・運用ポリシーまで、Claude / Claude Code を安全に導入するための確認項目を6カテゴリで整理。導入プロジェクトの進捗管理・監査証跡としてそのままご活用いただけます。
※Amazon Web Services、"Powered by Amazon Web Services"ロゴ、およびブログで使用されるその他のAWS商標は、米国その他の諸国における、Amazon.com, Inc.またはその関連会社の商標です。
※このブログで参照されている、Anthropic、Claude、Claude Code、Claude Cowork は、Anthropic, PBCの米国およびその他の国における商標または登録商標です。
※このブログで参照されている、GitHub は、GitHub, Inc. の米国およびその他の国における商標または登録商標です。