記事公開日
【Microsoft Foundry】モデルルーターを試してみた

この記事のポイント
Microsoft Foundryのモデルルーターは、1つのデプロイの背後でプロンプトごとに最適なLLMを自動選択する仕組みです(2026年10月時点)。
- モデル選びをルーターに任せられる:
プロンプトの複雑さを分析し、OpenAI・Anthropicなど複数ベンダーのモデルから振り分けます。 - モードで挙動がはっきり変わる:
筆者の検証では、品質モードは全ターンgpt-5、コストモードはgpt-5-nano/gpt-5-miniが選ばれました。 - 制約を知って使う:
コンテキストウィンドウは基になるモデルのうち最小のものに制限されるため、モデルサブセットの設計が重要です。
生成AIアプリで「どのモデルを使うか」に悩んだことはありませんか?
高性能モデルは「こんにちは」にもコストと時間がかかり、安価なモデルでは難しい質問に物足りなさが残ります。
そこで今回は、プロンプトごとにモデルを自動で選んでくれるMicrosoft Foundryの「モデルルーター」を試してみました。
モデルルーターとは?
モデルルーターは、プロンプトをリアルタイムで分析し、最適なLLM(大規模言語モデル)へ振り分けるトレーニング済みの言語モデルです。
アプリからは「1つのデプロイ」として呼び出せるため、モデルを切り替えるロジックを自分で書く必要がありません。
最新バージョン(2025-11-18)では、OpenAI・Anthropic・DeepSeek・Meta・xAIのモデルが振り分け対象です。
参考:Microsoft Foundry のモデル ルーター | Microsoft Learn
呼び出し方は通常のモデルと同じで、modelパラメーターにデプロイ名を指定するだけです。
実際に回答したモデルは、レスポンスのmodelフィールド(例:gpt-5-mini-2025-08-07)で確認できます。
なぜ自前で振り分けを作らないのか:
自作するには、モデルごとの品質・コスト比較や判定ロジック、新モデルが出るたびの見直しが必要です。
モデルルーターはこれをマネージド(Microsoft側で管理)で行い、プロンプトは判断に使われますが保存されないと明記されています。
3つのルーティングモード
ルーティングモードでは「どこまで品質差を許してコストを下げるか」を選べます。
デプロイ時の「カスタム設定」で指定し、未指定ならバランスになります。
| モード | 選び方(公式より) | 向いている用途 |
|---|---|---|
| バランス(既定) | 最高品質との差が小さい範囲(例:1〜2%)で最もコスト効率の高いモデル | 汎用チャット |
| コスト | より広い品質差(例:5〜6%)を許容し、最もコスト効率の高いモデル | 大量・定型の処理 |
| 品質 | コストを考慮せず、最も品質が高いモデル | 複雑な推論・重要な出力 |
使い分け:迷ったらバランス、大量処理はコスト、品質が業務リスクに直結する処理は品質がおすすめです。
【検証】コストモードと品質モードを比べてみた
比較結果が分かりやすいように、モデルサブセットに3つ(gpt-5、gpt-5-nano、gpt-5-mini)セットして品質モードとコストモードで検証してみました。
結論として、同じ会話でも品質モードは全ターンgpt-5、コストモードはgpt-5-nanoとgpt-5-miniが選ばれました。
品質モード(model-router-3)とコストモード(model-router-2)をプレイグラウンドで並べ、「こんにちは」→「QESの会社紹介を3行で」→「ありがとう」の順に送っています。
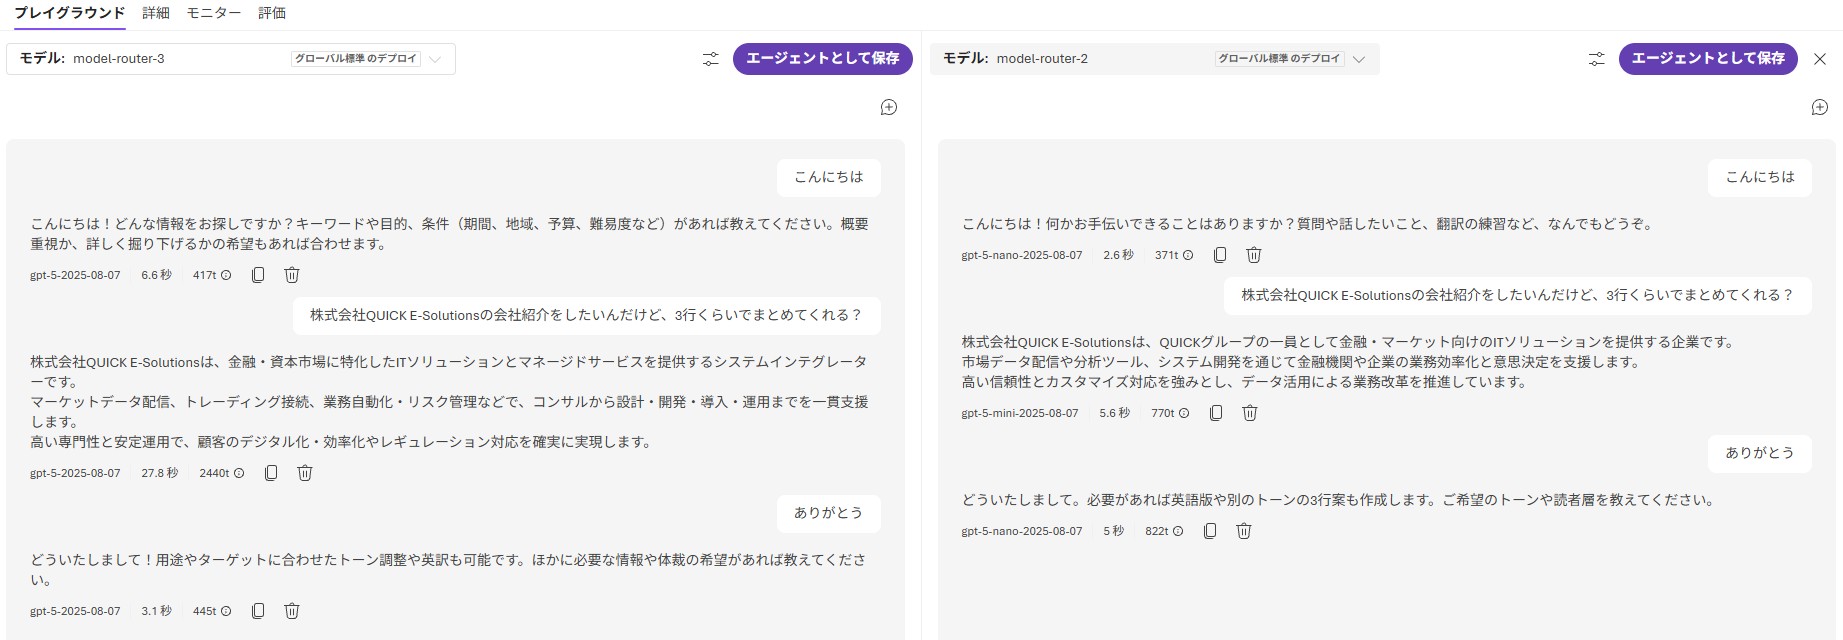
| メッセージ | 品質モード | コストモード |
|---|---|---|
| こんにちは | gpt-5/6.6秒 | gpt-5-nano/2.6秒 |
| 会社紹介を3行で | gpt-5/27.8秒 | gpt-5-mini/5.6秒 |
| ありがとう | gpt-5/3.1秒 | gpt-5-nano/5秒 |
品質モードは、あいさつにもgpt-5を使う「品質最優先」の挙動でした。
コストモードは、簡単なメッセージにnano、文章生成にminiと、難しさに応じて切り替えています。
会社紹介はどちらも依頼どおり3行程度で返しており、このくらいの用途ならコストモードでも十分と感じました。
ただし3往復だけの小さな検証なので、実際のプロンプトで評価することをおすすめします。
導入前の注意点
便利な反面、複数モデルをまとめて扱うことによる制約があります。
特に次の3点は事前に押さえておきましょう。
- コンテキストウィンドウは最小モデルに合わせられる:
長いプロンプトを扱う場合は、大きいコンテキストに対応するモデルだけをモデルサブセット(振り分け対象の指定)に含めます。 - Claudeは事前デプロイが必要:
Claudeを対象にする場合は、先に同じFoundryアカウントへClaudeモデルをデプロイしておく必要があります。 - 想定質問で十分なコストメリットがあるか確認する:
どのモデルに振り分けられるかはプロンプト次第で、安価なモデルに回る割合が削減効果を左右します。
導入前に実際の想定質問を流し、レスポンスのmodelフィールドで振り分け割合を確かめて、十分なコストメリットが出るかを確認しましょう。
モデルルーター自体にも入力トークンに応じた料金がかかるため、その分も含めて比較するのがおすすめです。
このほか、推論モデルが選ばれるとtemperatureなどが無視される点や、利用できるモデルがリージョンで異なる点も公式に記載があります。
参考:モデル ルーターの使用方法 | Microsoft Learn
よくある質問
Q. モデルルーターとは何ですか?
Microsoft Foundryで提供される、プロンプトごとに最適なLLMを自動で選ぶ仕組みです。
1つのデプロイとして呼び出せるため、モデル切り替えのロジックを作る必要がありません。
Q. どのモデルが回答したか確認できますか?
できます。
APIレスポンスのmodelフィールドに、回答したモデル名が入ります。
プレイグラウンドでも各応答の下に表示されます。
Q. 長いプロンプトでエラーになるのはなぜですか?
コンテキストウィンドウが、基になるモデルのうち最小のものに制限されるためです。
プロンプトを短くするか、大きいコンテキストに対応するモデルだけをサブセットに含めて対処します。
まとめ:モデル選びはルーターに任せてみよう
今回の学びは3つです。
- モデルルーターは1つのデプロイで複数モデルを自動で使い分けてくれる
- ルーティングモードで品質とコストのバランスを選べ、挙動の差もはっきり出る
- コンテキストウィンドウなどの制約を踏まえ、モデルサブセットを設計する
まずはバランスモードでデプロイし、いつものプロンプトを試してみてはいかがでしょうか。
QUICK E-Solutionsでは、AIを活用した業務効率化・システム導入のお手伝いをしております。
それ以外でも QESでは様々なアプリケーションの開発・導入を行っております。提供するサービス・ソリューションにつきましては こちら に掲載しております。
システム開発・構築でお困りの問題や弊社が提供するサービス・ソリューションにご興味を抱かれましたら、ぜひ一度 お問い合わせ ください。
※このブログで参照されている、Microsoft、Azure、Microsoft Foundryは、米国およびその他の国におけるMicrosoft Corporationの商標または登録商標です。
※OpenAI、GPTはOpenAIの商標または登録商標です。Claude、AnthropicはAnthropic PBCの商標または登録商標です。
※その他、記載されている会社名・製品名は各社の商標または登録商標です。